
一人ひとりに寄り添うAIを、継続して届けるには
商品レビュー生成の比較実験から考える、パーソナライズの品質と運用コスト
- AI
生成AIを顧客対応や業務支援に活用する際には、一人ひとりの目的や好みに合った内容を届けることが重要です。こうした個人に応じた内容や表現の調整を「パーソナライズ」と呼び、LLM(Large Language Models:大規模言語モデル)の活用でも研究が進められています。利用者が指定した好みや過去の行動などを生成時に参照する方法や、追加学習によって利用者の特徴をモデルに反映する方法など、さまざまなアプローチがあります。本研究では、その中でも、利用者が過去に書いた文章を活用し、文体や好みを新たに生成する文章に反映する方法に着目しました。
一人ひとりに合った文章をサービスとして継続的に提供するには、生成品質と運用コストの両立が課題となります。利用者の特徴を詳しく伝えようと過去の文章を多く入力すると、入力が長くなり、API利用コストが増える要因となります。では、過去の文章をそのまま与える方法と、文体や好みを短いプロファイルにまとめて与える方法では、品質とコストにどのような違いが生まれるのでしょうか。プロファイルの作成や再利用も含め、継続的な運用を見据えた比較が必要です。
こうした背景のもと、当社AIトランスフォーメーションセンターでは、商用LLMの活用を見据えた「ユーザー履歴表現におけるコストと生成品質のトレードオフ検証」に関する研究を実施しました。本研究では、商品レビューのパーソナライズ生成を題材に、ユーザー履歴の与え方による違いを比較しています。本研究をまとめた論文(Raw Histories or Compact Profiles? A Cost-Aware Empirical Study of User History Representations for Personalized Review Generation with LLMs)は、データマイニング・機械学習分野の主要な国際学会であるICDM(IEEE International Conference on Data Mining)の併設ワークショップ「IEEE ICDM International Workshop on AI for Personalization(WAIP)」に採択されました。
本コラムでは、論文で得られた検証結果をもとに、商用LLMにおける生成品質とAPIコストの両立に向けた、ユーザー履歴の活用方法と運用設計のポイントについて、論文の執筆者であるAIトランスフォーメーションセンターの大沢 直史が解説します。
目次
ユーザー履歴をAIに伝える三つの方法
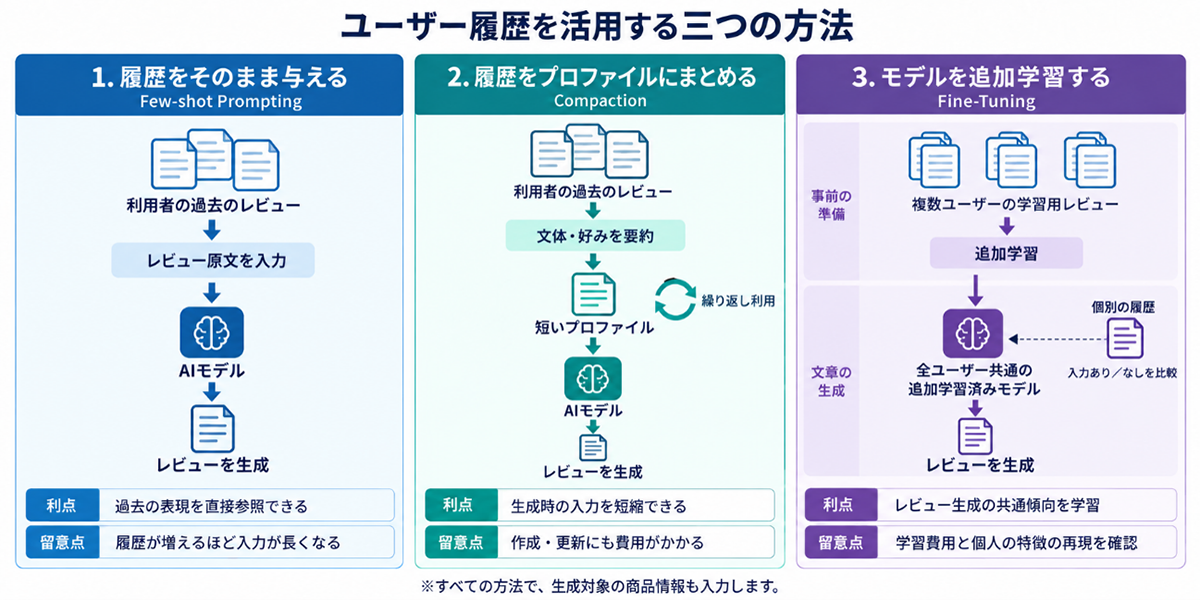
本研究では、ECサイトの商品レビューデータを使い、利用者の文体や好みを反映したレビューを生成する方法を比較しました。具体的には、過去のレビューをそのままAIに与える方法、特徴を短いプロファイルにまとめて与える方法、複数のユーザーのレビューデータを使ってモデルを追加学習する方法の三つを検証しました。
【図解1:3つのアプローチの構造比較】
-
1.過去のレビューをそのまま与える(Few-shot Prompting)利用者が過去に投稿したレビューを、文章生成の指示とともにAIへ入力する方法です。本研究では、入力するレビューの上限を1件、5件、10件、30件として比較しました。
・メリット: 追加学習を行わずに利用でき、AIが過去の具体的な言葉遣いや文章構成を直接参照できます。
・デメリット: 入力するレビューが増えるほど入力が長くなるため、入力費用を考慮する必要があります。 -
2.履歴を要約してプロファイルにする(Compaction)過去のレビューから、文体や好み、よく使う表現、文章構成などの特徴を抽出し、短いユーザープロファイルにまとめる方法です。文章を生成する際には、レビュー原文の代わりに、このプロファイルをAIに与えます。
・メリット: 生成時の入力を短くできます。作成したプロファイルを繰り返し利用できれば、継続的なAPI利用コストの削減が期待できます。
・デメリット: プロファイルの作成・更新にも費用がかかります。また、要約によって過去の文章の細かな特徴が失われる可能性があります。 -
3.モデルを追加学習する(Fine-Tuning)複数のユーザーの学習用レビューデータを使って、事前学習済みのモデルを追加学習する方法です。本研究では、ユーザーごとに個別のモデルを作ることはコストや、我々の想定する運用を考えた際に非現実的であると考え、比較のみを目的として全ユーザーで共通の追加学習済みモデルを利用しました。
文章を生成する際には、個別のユーザー履歴を与えない方法と、過去のレビューも併せて与える方法を検証しました。
・メリット: レビュー生成に共通する傾向をモデルに学習させられます。生成時に個別の履歴を入力しない場合は、履歴に由来する入力コストを抑えられます。
・デメリット: 追加学習に費用がかかります。また、全ユーザー共通の学習だけで、一人ひとりの文体や好みをどこまで反映できるかを確認する必要があります。
比較実験から見えた、品質とコストを両立するための三つのポイント
本研究では、生成した文章が利用者の実際のレビューとどの程度似ているかを自動評価するとともに、人が読んで「その利用者らしい」と感じるかをクラウドソーシングによる実験を用いて評価しました。さらに、文章生成だけでなく、プロファイルの作成やモデルの追加学習も含めたAPI利用コストを試算しました。
その結果から、サービスの設計・運用を考える上で、次の三つのポイントが見えてきました。
履歴の増やし方とプロファイルの使い方で、費用対効果は変わる
商品レビュー生成の実験結果、GPT-5.4・Amazon Fashion・評価対象749件
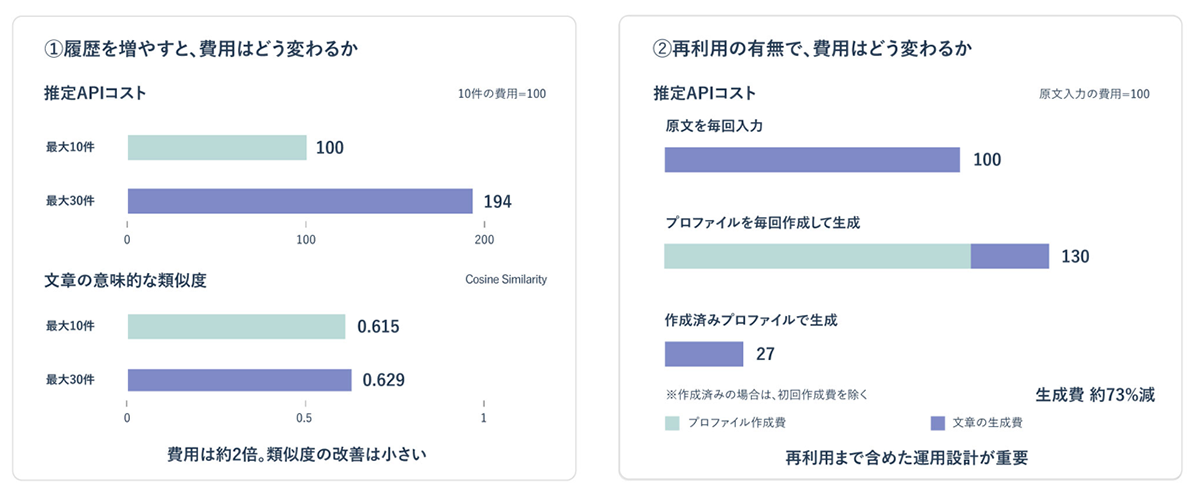 比較条件:左は原文参照の上限10件/30件。右は原文・プロファイルとも履歴の上限30件。実際の参照件数は利用者により異なります。
費用は実験時のAPI料金に基づき、APIのキャッシュ割引を適用しない試算です。右の「生成費 約73%減」は原文入力との比較で、初回のプロファイル作成費を含みません。
類似度は実際のレビューとの意味的な近さを測る指標で、文章の正確さや「その人らしさ」を直接示すものではありません。
出展:Raw Histories or Compact Profiles?(Table1・Figure 2)をもとに作成。数値は表示時に丸めています。
-
①過去の文章は、多く与えればよいとは限らないGPT-5.4で原文入力とプロファイル入力を比較した条件では、過去のレビューを最大30件そのまま与える条件で、最も高い自動評価スコアが得られました。ただし、参照する履歴を増やしたときの改善幅に対して、コストの増加は大きくなりました。
例えば、GPT-5.4で参照件数の上限を10件から30件に増やすと、文章の意味的な類似度はわずかに改善する一方、生成1回あたりの推定APIコストは約2倍になりました。
サービスを設計する際には、履歴を追加することで得られる改善が、追加費用に見合うかを確認することが重要です。今回の結果だけで最適な履歴件数を決めることはできませんが、必要な品質を満たす入力の量を見極める判断材料になります。 -
②短いプロファイルは、繰り返し使うことで費用対効果が高まる過去のレビューを短いプロファイルにまとめる方法では、レビュー原文を与える方法に比べて、生成時の入力を大幅に短縮できました。単語や表現の一致を測る自動評価スコアは下がったものの、文章の意味的な類似度は比較的近い値を保ちました。
また、クラウドソーシングによる人手評価で「利用者らしい」と選ばれた割合は、原文を与える方法とプロファイルを与える方法でほぼ同じでした。ただし、小規模な評価で判断にもばらつきがあり、両者の品質が同等と確認されたわけではありません。短いプロファイルでも、利用者の特徴を反映できる可能性を示す結果と捉えています。
費用面では、作成済みのプロファイルを使って生成する場合、GPT-5.4・履歴上限30件の比較条件で、レビュー原文を与える方法より生成時の推定APIコストを約7割削減できました。この割合はAPIのキャッシュ割引を適用しない試算に基づき、最初のプロファイル作成費は含まれていません。
毎回プロファイルを作り直すと、作成費を含む総コストは原文を与える方法より高くなる場合があります。プロファイル化を選ぶ際には、同じプロファイルを何回使えるか、どの程度の頻度で更新するかまでの運用を含めて考える必要があります。 -
③追加学習の効果は、個人の情報の与え方も含めて評価する今回検証した、全ユーザー共通の追加学習済みモデルでは、生成時に個別の履歴を与えない条件の評価結果は限定的でした。過去のレビューも併せて与えると、複数の自動評価指標で改善が見られました。
ただし、追加学習の評価は他の方法と使用モデルや評価対象が異なるため、この結果からファインチューニング全般の優劣を判断することはできません。また、ユーザーごとに個別のモデルを追加学習する方式も、今回は検証していません。
サービス設計では、モデルを追加学習するかどうかに加え、生成時に一人ひとりの情報をどう伝えるかも検討する必要があります。追加学習を行っただけで十分な個別対応ができると考えず、目的に合った品質が得られるかを確認することが重要です。
-
※結果は、今回の商品レビュー生成の実験条件に基づきます。費用は実験時のAPI料金と入出力の長さから、キャッシュ割引を適用せずに算出した推定値です。実際の費用は、利用するモデル、キャッシュの適用状況、プロファイルの再利用回数や更新頻度によって変わります。
サービス導入に向けた、設計・運用の三つの判断ポイント
今回の研究は、商品レビュー生成という限られた条件での比較ですが、生成AIのパーソナライズをサービスに取り入れる際の判断材料になります。導入を検討する際には、次の三つの観点を確認することが重要です。
-
1.サービスに必要な品質を決めるパーソナライズに求める品質は、用途によって異なります。利用者の言葉遣いやよく使用する単語を細かく反映したいのか、好みや重視する点が伝わればよいのかによって、評価の仕方も変わります。
自動評価のスコアに加え、利用者や業務担当者が出力を読んで、目的に合っているかを確認することが必要です。文章の類似度だけでなく、内容の正確さや修正の手間など、実際の利用に必要な品質も確認した上で、手法を選びます。 -
2.作成・更新・再利用を含めて費用を見積もるプロファイル化の費用対効果は、同じプロファイルを何回利用できるかによって変わります。同じ利用者が繰り返し使うサービスでは、プロファイルの再利用によって、生成時の費用を抑えられる可能性があります。
一方、利用者の好みが変わりやすい場合や、新しい履歴を頻繁に反映する場合は、更新費用も考慮する必要があります。モデルを追加学習する場合も、学習費用を含め、想定する利用回数に応じた総コストで比較することが重要です。
生成AIの運用コストを抑える仕組みも進化しています。例えば、OpenAIのAPIでは、同じ入力部分の計算結果を再利用する「プロンプトキャッシュ」が提供されています[1]。履歴を短いプロファイルにまとめて再利用する工夫に、こうした機能を組み合わせることで、利用条件によっては、さらにコストを抑えられる可能性があります。 -
3.履歴は、量だけでなく選び方も考える利用者の特徴を詳しく伝えようと、過去の文章を多く入力しても、そのすべてが生成に役立つとは限りません。パーソナライズを扱う先行研究「LaMP[2]」でも、入力長や処理費用の制約を踏まえ、利用者の履歴から関連する情報を選んで与える方法が検証されています。
今回の実験でも、参照する履歴を増やしたときの評価スコアの改善に対して、費用の増加が大きくなる傾向が見られました。サービス設計では、履歴を追加したときに、必要な品質がどれだけ改善するかを確認することが重要です。
その上で、入力する履歴の量を調整する、特徴をプロファイルにまとめるといった方法を検討します。関連する履歴を選んで与える方法も、今回の実験では比較していませんが、検討すべき選択肢の一つです。
おわりに:生成AIの価値を、継続して届けるために
一人ひとりに合った生成AIの支援を継続して提供するには、生成品質と運用コストの両方を考える必要があります。今回の研究では、利用者の履歴をどのように表現するかに加え、作成したプロファイルを再利用できるかが、費用対効果を左右することが分かりました。
電通総研のAIトランスフォーメーションセンターでは、お客様の業務課題に向き合うAIコンサルティングと、Know NarratorをはじめとするAI製品の開発に取り組んでいます。その中で、新しい技術をどのように業務に適用できるかを探り、製品やシステムとして実現するための研究開発を進めています。
今回の研究も、一人ひとりに合わせた文章生成を、品質と費用の両面から実用に近づけるための取り組みです。こうした研究で得られる知見を製品開発やお客様への提案に生かし、AIによる業務の改善や新たなサービスの実現につなげていきます。
今後も電通総研は、先端AI技術の実践的な研究と検証を通じて得られたナレッジを社会やコミュニティへオープンに還元し、企業や社会の健全なAIトランスフォーメーションを支援してまいります。
-
※本記事は、電通総研の研究成果である論文「Raw Histories or Compact Profiles? A Cost-Aware Empirical Study of User History Representations for Personalized Review Generation with LLMs」の内容をもとに作成されました
参考情報
-
[1]OpenAI. Prompt caching. https://developers.openai.com/api/docs/guides/prompt-caching
 (2026年10月26日参照)
-
[2]Salemi, A. et al. (2024). LaMP: When Large Language Models Meet Personalization. ACL 2024. https://aclanthology.org/2024.acl-long.399/

大沢 直史 Xイノベーション本部 AIトランスフォーメーションセンター
前職のテレビ局にて、番組制作に関する放送技術業務および放送支援システムの開発に従事した後、電通総研に入社。企業向け生成AIソリューション「Know Narrator(ノウ ナレーター)」の開発を担当。現在は研究開発のリードとして、生成AIソリューションを支える技術の研究開発と、実用化に向けた技術調査に従事。